同一段逻辑,三种写法,最快的那版快 257 倍:
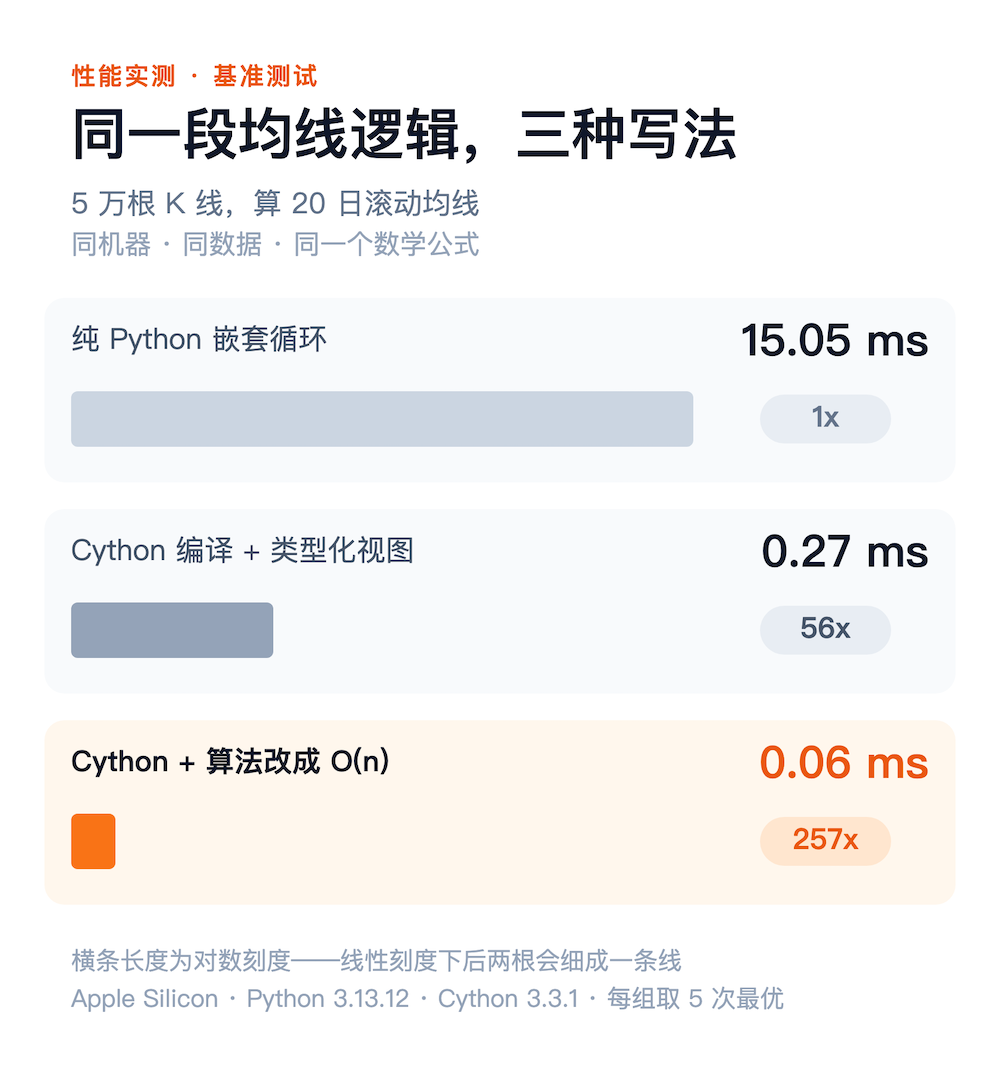
没换语言(还是 Python 语法),没换机器,也没改数学公式——只是把「谁来算」和「怎么算」这两件事搞对了。
这件事在大 QMT 里格外要紧——因为所有策略共用同一条 Python 线程,你花的每一毫秒都是公共开销。
上一篇《QMT 单线程指南(一):多策略怎么排队、该不该把策略写在一起》把执行模型讲透了:所有策略共享同一条 Python 线程,串行、不可抢占。它的第七问给了四层提速思路——数据 → 计算 → 回调 → 架构,但「计算层」只落了一句话:
禁止 Python 循环算指标,全部交给 pandas/NumPy/TA-Lib(QMT 内置自带),
rolling(20).mean()是 C 实现的向量运算。
这句话对,但没说完。那些库的 C 内核到底在替我们干什么?QMT 3.12 自带了哪些「带 C 内核」的库?什么时候连库都不够用,得自己上 Cython? 这一篇就回答这三个,外加另外八个。
为什么值得认真对待:单线程模型下,你省下的每一毫秒不只是自己的,而是同一客户端上所有策略一起受益;反过来说,你在回调里多跑的每一次 Python 循环,全群买单。
拆成十一个问题,每个问题一句短答、一段展开。能用实测数据说话的就上数据——所有数字都是我在自己机器上跑出来的,实测环境放在文末。
Q1:回测慢、实盘卡,先怀疑什么?到底哪一步耗时大?
短答:先分清是「取数慢」「逻辑慢」还是「柜台慢」,别一上来就优化代码。
策略的耗时只有三个来源:
| 来源 | 典型症状 | 优化手段 |
|---|---|---|
| 取数/IO | 每根 bar 都调 get_market_data_ex,回测像卡住 |
一次取够、缓存、增量更新 |
| 逻辑计算 | CPU 跑满,单根 bar 耗时几十 ms | 本文重点:向量化 / Cython |
| 柜台查询 | 每个 tick 查账户/委托/持仓 | 降频、is_new_bar、定时器 |
判断方法很土但很有效——在可疑处打点:
1 | import time |
如果「取数」占 90%,后面讲的 Cython 一点用都没有。 这是最常见的浪费——很多人优化了半天循环,瓶颈其实在一次多余的行情调用上。
Q2:Python 到底慢在哪?
短答:C 算一次加法就只是加一次;Python 算一次加法,得先把数字从盒子里拆出来,算完再装进一个新盒子,最后登记一下这个新盒子归谁管。
同样一个 3.14,在 C 里是内存中裸的 8 个字节;在 Python 里是带包装的盒子——里装 8 字节,外贴「我是 float」和「有 3 处在指着我」两张标签。于是 s += x 的动作里,只有「相加」那一步真在算数:
| 动作 | C | Python |
|---|---|---|
| 取数 | 读 8 字节 | 取指针、拆包装 |
| 确认类型 | 编译期已定 | 运行时读标签 |
| 相加 | 加 | 加 |
| 存结果 | 写回寄存器 | 新建盒子、引用计数加减 |
你以为在「算 100 万次加法」,实际是在「打包拆包 100 万次,顺手算了个加法」。 这不是修辞——500 万个浮点数求和,实测每个元素的耗时:
| 写法 | 每元素 |
|---|---|
纯 Python:for x in lst: s += x |
6.3 ns |
| Cython 类型化循环(一模一样的逻辑) | 0.48 ns |
np.sum(arr) |
0.11 ns |
6.3 ns 粗算有二十来个时钟周期,而一次加法本身一个周期就完——剩下二十来个周期全是包装费。
第二层是解释费。一次循环要念六条字节码(FOR_ITER → STORE_FAST → LOAD_FAST_LOAD_FAST → BINARY_OP → STORE_FAST → JUMP_BACKWARD),每条都得「取、判断这是哪条、分派」;C 里这一串早就固定成机器指令流。CPython 3.11 那个「提速 25%」,很大程度上就是把两条压栈融合成了 LOAD_FAST_LOAD_FAST——优化的是「念」的速度,包装还得拆;而 QMT 的 3.6 连这个融合都没有,所以纯 Python 循环还要更慢一截。
所以数值循环想快,方向只有一个:别用盒子。NumPy / pandas 把整段数据一次性倒出来批量算(Q6、Q7),Cython 让编译器直接按 8 字节数组出机器码、盒子在代码里根本不存在(Q8),算法优化则是少拆几百万次(Q9)。
那为什么不干脆全用 C?——下一个问题。
Q3:那我用 C 把整个策略重写一遍行不行?
短答:不行,也不必要。QMT 只认 Python,C 只能以「编译好的模块」形式被 import。
三个现实约束:
- QMT 的策略入口必须是 Python:
init(ContextInfo)/handlebar(ContextInfo)是 Python 函数,C 没法直接提供; - 写 C 的成本极高:字符串处理、异常、内存管理全要自己来,一个越界就是崩溃而不是 traceback,实盘环境里这是灾难;
- 改一次编译一次:调参数这种高频操作,在纯 C 工作流里会让人崩溃。
正确姿势是分层:Python 负责调度和业务逻辑,C 只负责那 5% 真正吃 CPU 的热点函数。这就引出了下一个问题。
往下还有八个问题、三个小节,先把目录摆在这儿:
- Q4:什么是「胶水语言」?为什么这是正确分工?
- Q5:我的策略里,热点通常在哪?
- Q6:NumPy 向量化够用吗?什么时候必须上 Cython?
- Q7:QMT 3.12 自带的库里,哪些是「带 C 内核」的?
- 但「带 C 内核」不等于「一定快」:pandas 的固定开销
- 3.6 → 3.12,这条线上发生了什么
- TA-Lib 为什么单独值得说
- Q8:Cython 不加类型有用吗?(最容易被忽略的一点)
- Q9:语言优化和算法优化,哪个先做?
- Q10:Cython 模块怎么放进 QMT?
- Q11:提速的代价是什么?
末尾还有三节:计算层的四条「零成本」提速(不写一行 C 就能拿到的那部分)、提速的优先级(先量 → 再算法 → 再向量化 → 最后 Cython)、以及实测环境与数据说明(本文所有数字的出处)。
继续阅读请用微信扫描公众号:
⚠️ 风险提醒与免责声明
- 本文为技术分享与性能测试记录,仅供编程学习与技术研究,不构成任何投资建议、荐股意见或收益承诺。
- 文中 benchmark 数据来自本机实测(Apple Silicon / Python 3.13.12),你的环境(Windows/x86、不同 Python 版本)数值会有差异,请以实测为准。
- 涉及的
passorder等交易接口会在实盘模式下真实发出委托,任何策略在实盘前必须先在 QMT「模拟信号模式」或「模拟柜台」中充分验证。 - 因使用本文内容、代码或建议造成的任何盈亏,由使用者自行承担全部责任。量化交易涉及真实资金风险,入市需谨慎。
- QMT、迅投 为迅投公司或其关联公司的商标,本文为社区非官方整理,与官方无隶属关系。
- 本文由 AI 创作,请自行判断是否适用。